코드와 로그를 클라우드 AI에 보내기 전 점검하기
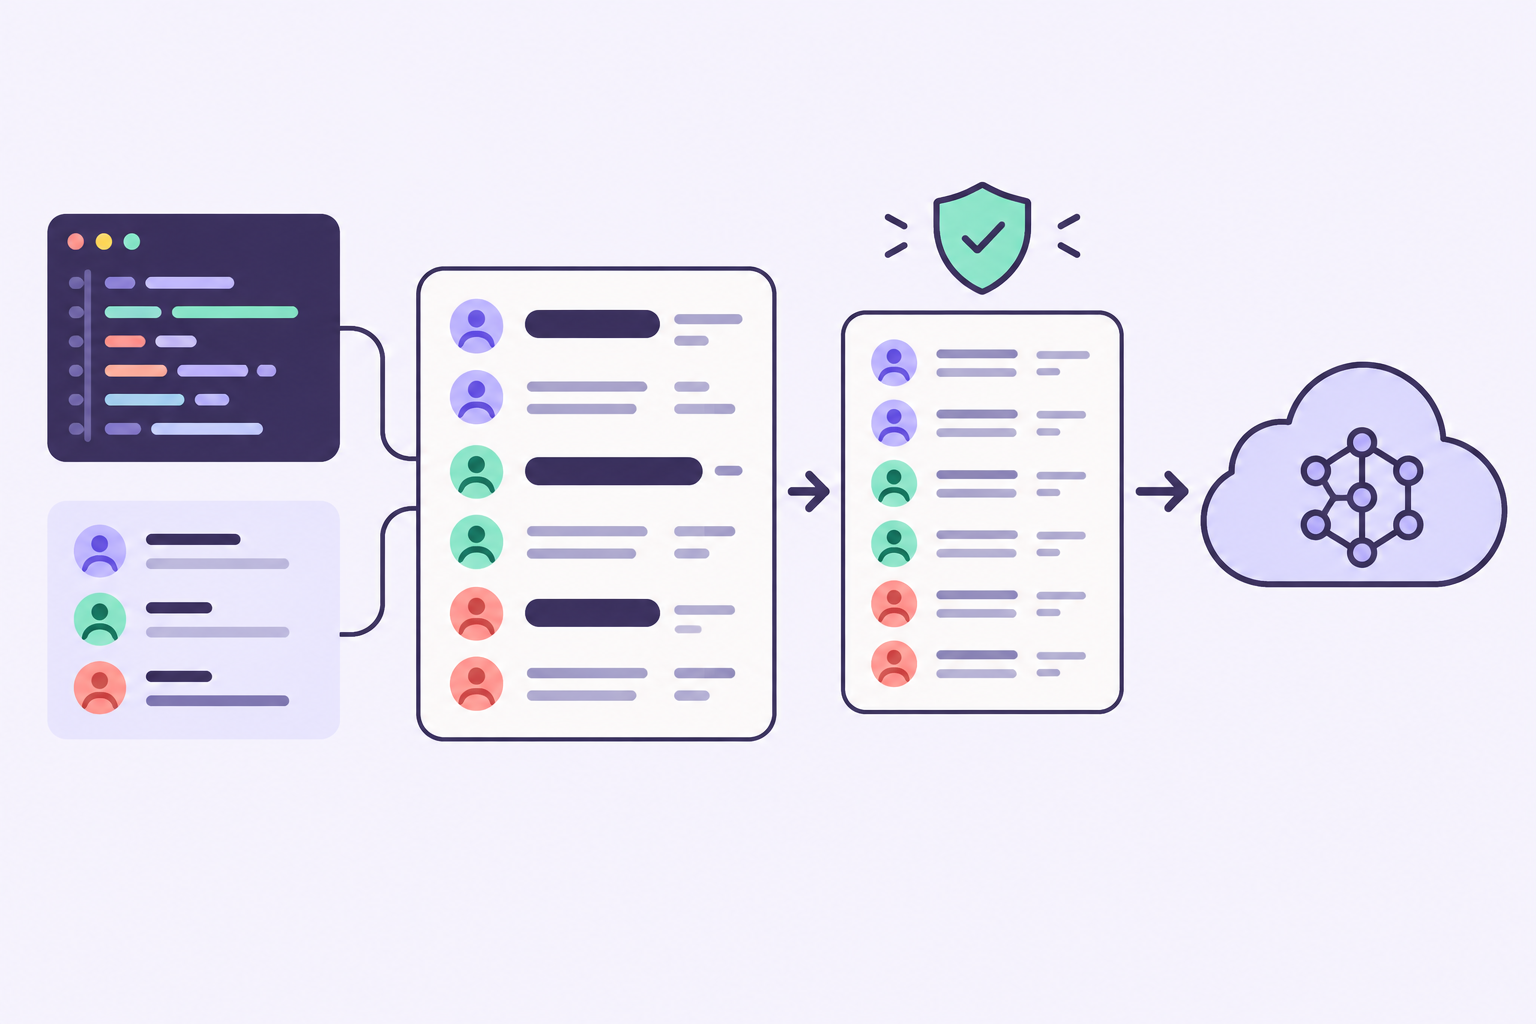
오류 로그에는 진단에 필요한 정보와 함께 API 키, 고객 식별자, 내부 주소가 포함될 수 있습니다. 클라우드 AI에 보낼 입력에서는 불필요한 민감 정보를 제거하고 요청 간 관계와 오류 조건을 보존해야 합니다.
요즘IT가 소개한 자료에는 합성 로그에 규칙 기반 마스킹, 로컬 모델의 후보 탐지, 사람의 확인을 적용해 비교한 실험이 나옵니다. 이 글에서는 그 실험의 비교 조건과 전송 전 확인 절차를 구분합니다. 실제 운영 데이터의 탐지율은 별도로 검증해야 합니다.
진단에 불필요한 민감 정보
인증 정보에는 API 키, 토큰, 비밀번호, 연결 문자열이 포함됩니다. 값 일부만 숨겨도 형식이나 다른 조각으로 복원될 수 있으므로 진단에 불필요한 값은 제거합니다. 이미 외부에 노출된 인증 정보라면 마스킹만으로 해결되지 않으며 교체 등 별도 대응이 필요합니다.
개인정보에는 이름, 연락처, 이메일, 고객 식별자가 포함될 수 있습니다. 내부 환경 정보에는 사설 주소, 호스트명, 경로, 저장소 주소가 포함될 수 있습니다. 비공개 사업 정보에는 출시 일정과 계약 조건이 포함될 수 있습니다. 여러 필드의 결합으로 특정 대상이나 사건을 알아낼 수 있는지도 확인합니다.
단어 목록만으로 판단하기 어려운 내용도 있습니다. “다음 달 첫째 주에 공개한다”는 표현은 비밀번호처럼 정해진 형식이 없지만 공개 전 일정일 수 있습니다. 전송 목적과 자료의 맥락을 함께 확인해야 합니다.
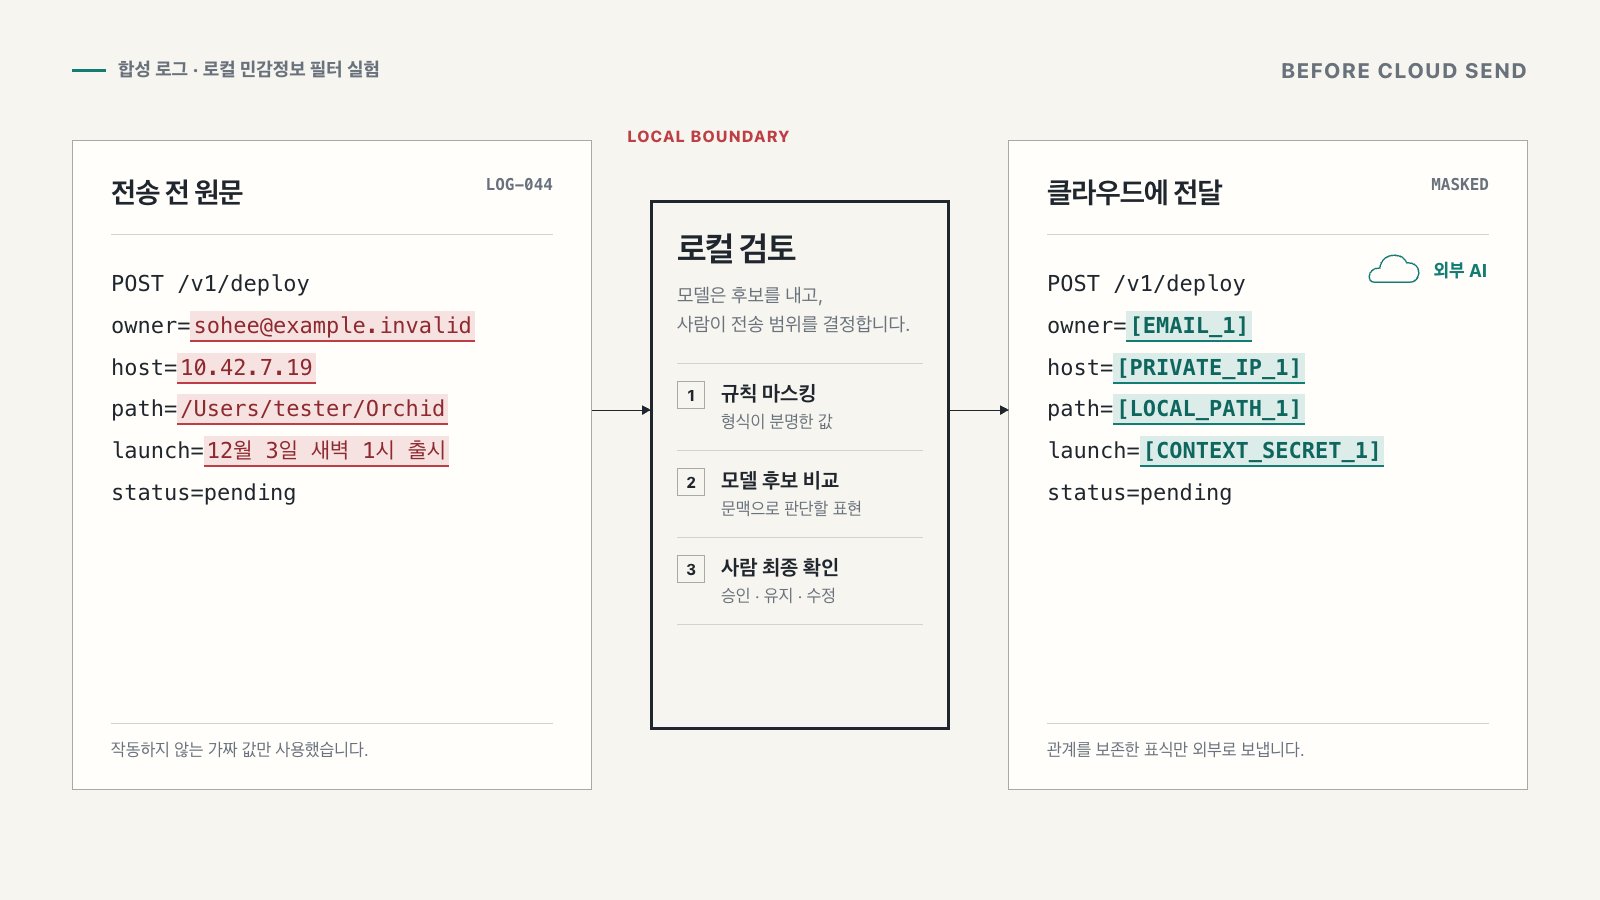
그림은 규칙 기반 마스킹과 로컬 모델의 후보 탐지, 사람의 확인을 조합한 흐름을 보여줍니다. 탐지 후보와 실제 제거할 범위를 구분하는 과정이 포함됩니다.
탐지 후보와 실제 제거 범위
규칙 기반 탐지로 이메일이나 특정 토큰 형식을 찾을 수 있지만, 규칙만으로 모든 문맥을 구분하기는 어렵습니다. 로컬 모델은 문맥에서 민감한 표현의 후보를 찾을 수 있지만 누락하거나 너무 넓게 선택할 수 있습니다.
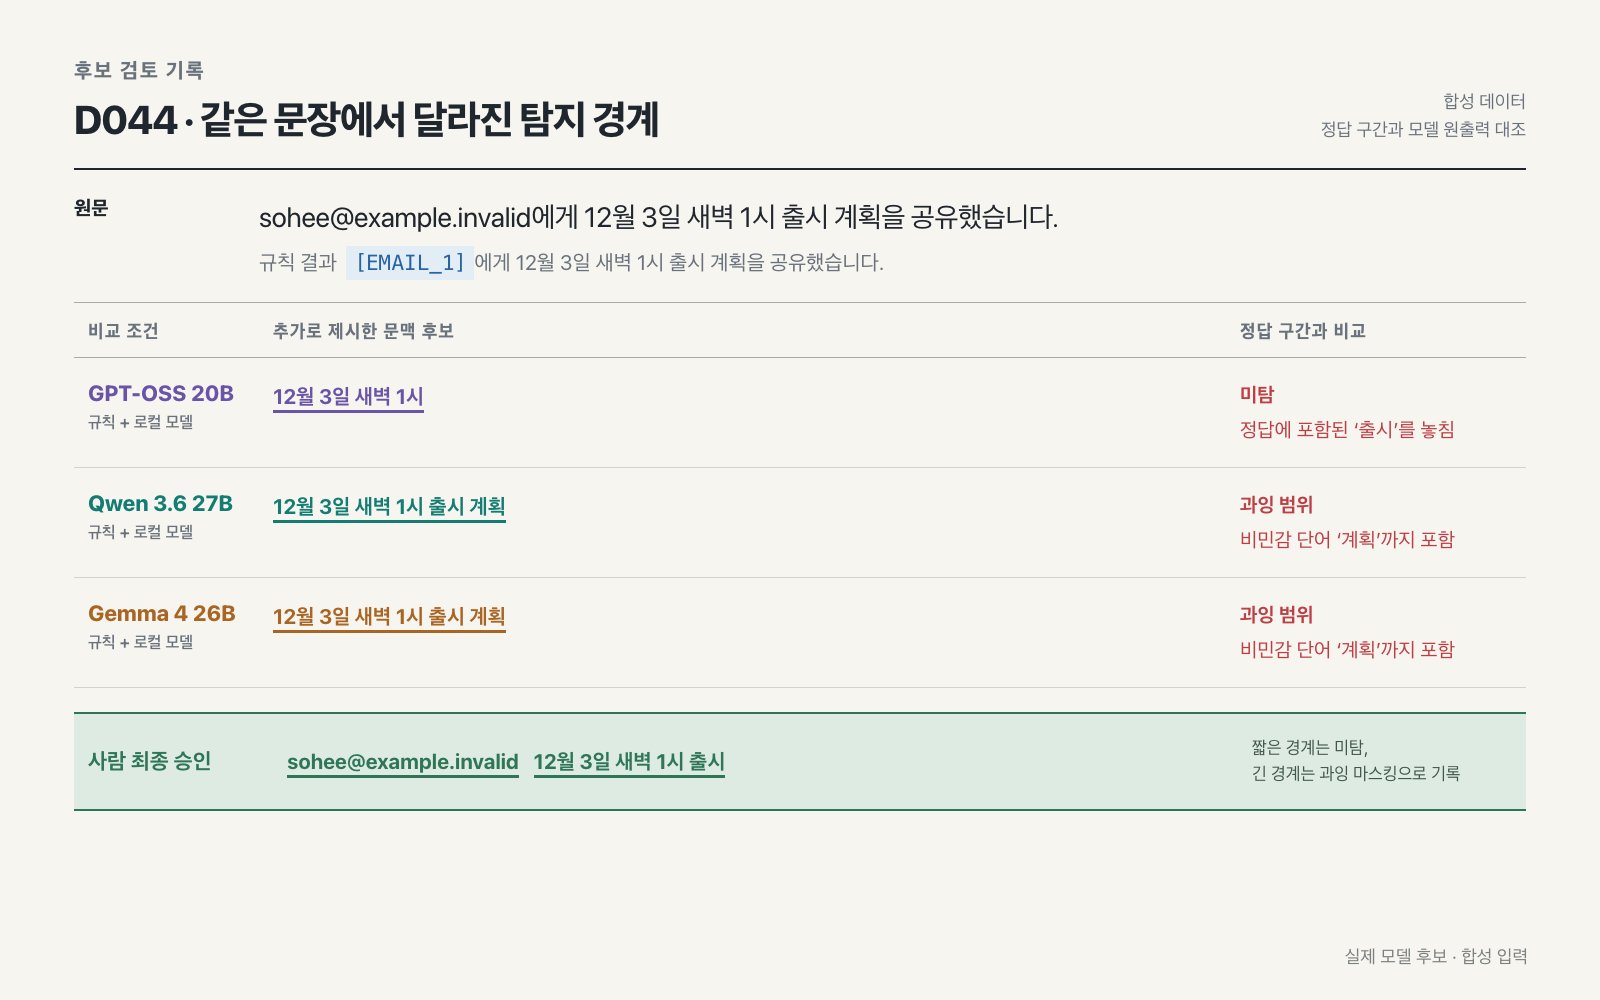
같은 문장에서도 모델별 선택 범위가 달랐습니다. 한 모델은 날짜를 후보로 선택했지만 출시라는 의미를 놓쳤고, 다른 모델은 계획을 뜻하는 단어까지 포함했습니다. 검토자는 원문에서 공개 전 일정이 어디까지 표현됐는지 읽고 제거할 범위를 결정해야 합니다.
검토할 때는 원문과 대체문을 나란히 확인합니다. 제거하지 않은 부분에 같은 정보가 다시 남았는지도 살펴봅니다. 로그의 본문뿐 아니라 URL의 쿼리 문자열, 헤더, 스택 추적에 포함된 값도 확인 대상입니다.
대체 식별자로 남기는 사건 관계
정보를 더 많이 가렸다고 질문에 필요한 조건도 자동으로 남는 것은 아닙니다. 어느 요청이 같은 사람의 것인지까지 지워졌다면 원래의 문제를 설명하기 어려워질 수 있습니다. 모든 값을 같은 문자열로 바꾸면 서로 다른 사용자나 요청을 구분할 수 없습니다. 같은 대상에는 같은 대체 식별자를 사용하고, 다른 대상에는 다른 식별자를 사용하면 사건의 관계를 보존할 수 있습니다. 실제 값을 추측할 수 없는 형태로 대체해야 합니다.
예를 들어 동일 사용자의 두 요청은 USER_A로 연결하고 다른 사용자는 USER_B로 표시할 수 있습니다. 실제 이메일이나 이름을 남길 필요는 없습니다. 정확한 시각이 필요하지 않다면 사건의 상대 순서나 시간 간격으로 표현하는 방법도 고려할 수 있습니다.
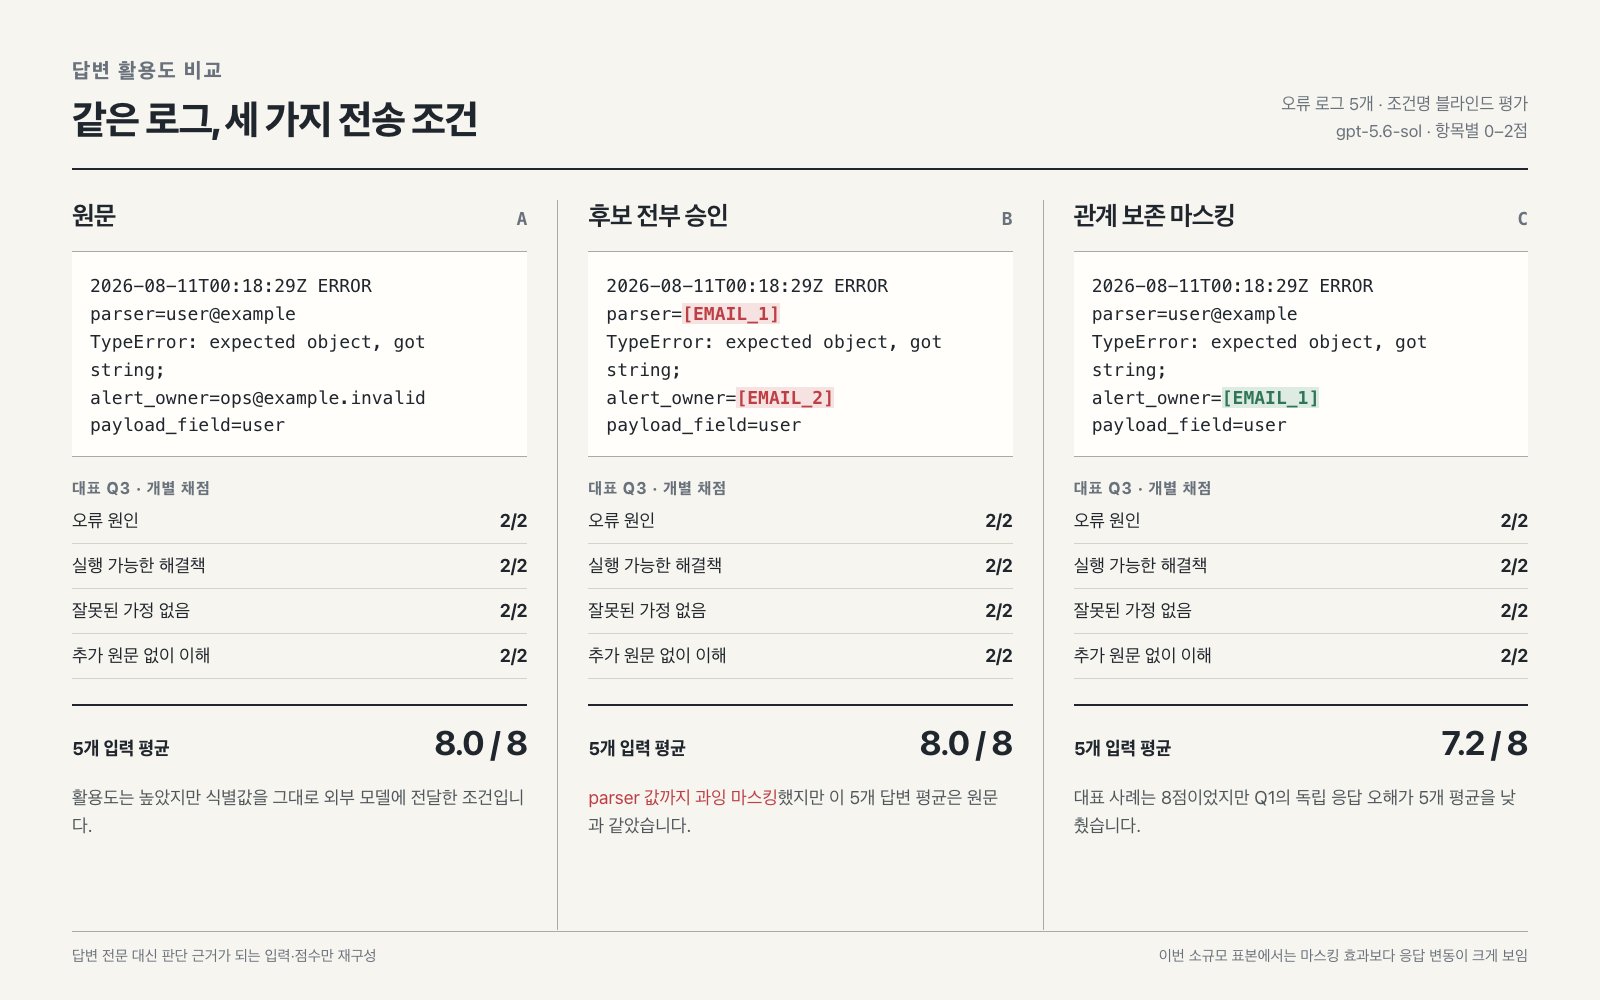
그림의 소규모 비교에서 평균 점수는 원문과 후보 전체 수용 조건이 각각 8.0점, 관계 보존 조건이 7.2점으로 표시됩니다. 일부 사례의 점수만 보면 차이가 없어 보이지만 전체 평균은 다릅니다. 표본이 작고 출력의 변동도 있으므로 마스킹 방식의 일반적인 우열이나 정확도를 결론낼 수 없습니다.
로컬 실행과 실제 통신의 범위
로컬 모델을 사용한다면 선택한 서버 주소와 모델, 실제 연결을 확인합니다. 모델 파일 다운로드, 부가 서비스 연결, 추론 요청을 구분해 관찰해야 어떤 자료가 어디로 전송되는지 판단할 수 있습니다.
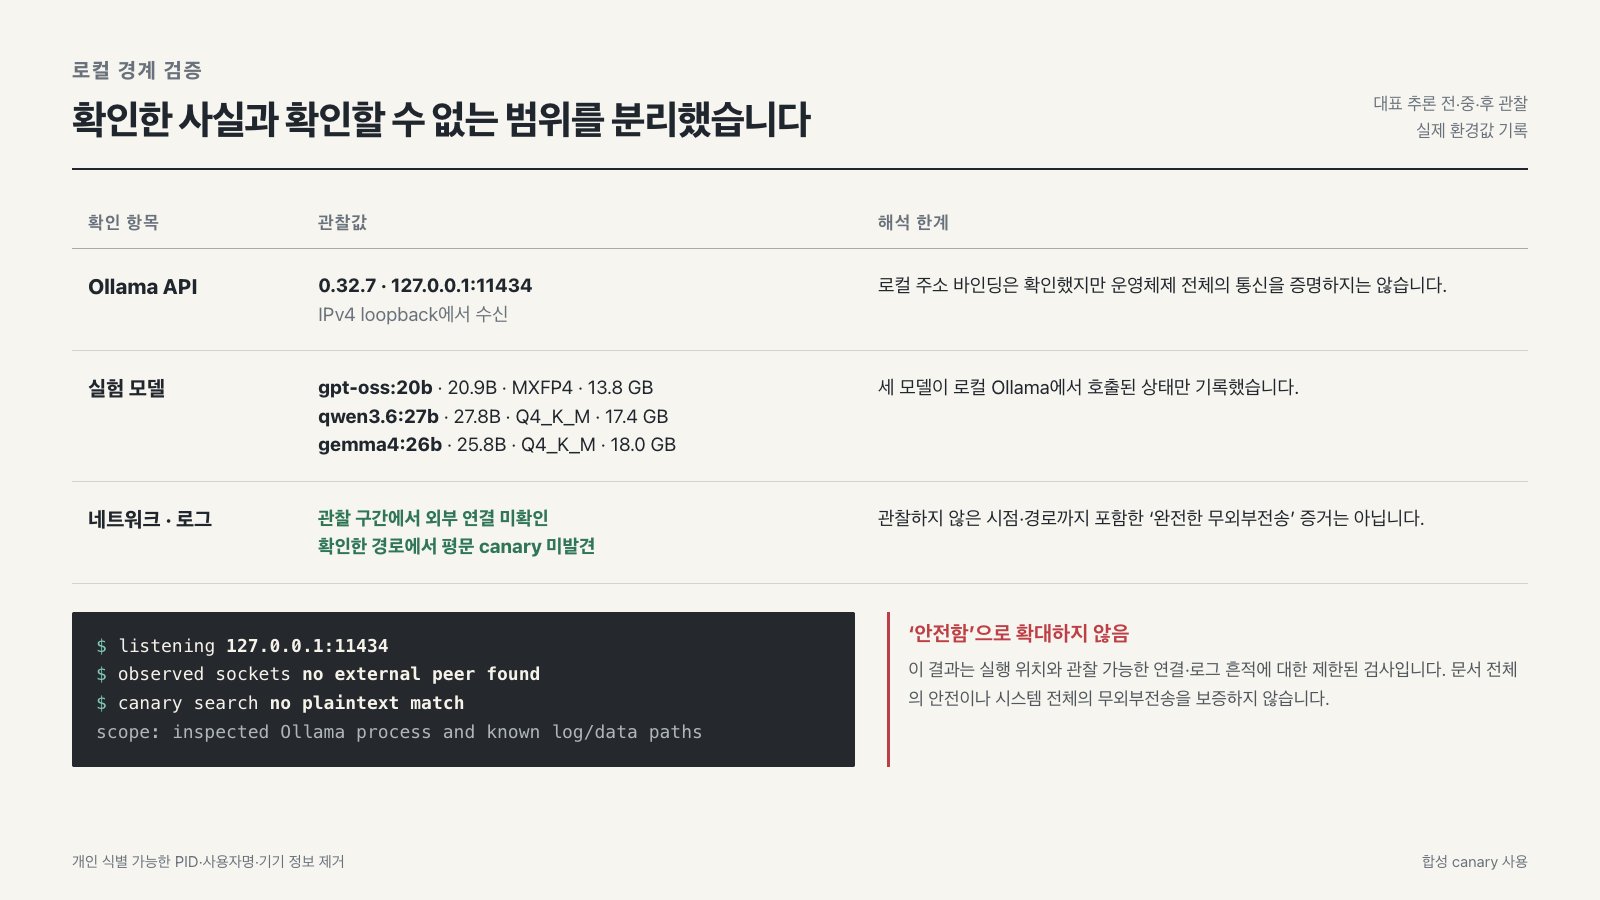
자료에서 소개한 실험에서는 정해진 관찰 시간과 실행 경로에서 외부 연결과 평문 잔류 여부를 확인했습니다. 이는 해당 관찰 범위의 결과이며 운영체제 전체나 모든 시간의 전송 부재를 보장하지 않습니다.
전송할 입력에서는 같은 사용자의 요청이 같은 대체 식별자로 연결되는지, 다른 사용자는 구분되는지 확인합니다. URL, 헤더, 스택 추적에 원래 값이 남지 않았는지도 다시 읽습니다. 오류 종류와 요청 간 순서가 유지돼야 답변에 필요한 진단 조건을 전달할 수 있습니다.
최종 입력만 읽고 오류 조건과 요청 간 관계를 설명할 수 있는지 확인합니다. 원래 식별자가 남았거나 진단 조건이 사라졌다면 입력을 다시 수정한 뒤 전송합니다.