pg_durable로 중단된 작업의 진행 상태 저장하기
문서를 읽고, 외부 API로 분류한 뒤, 결과를 데이터베이스에 저장하는 작업을 생각해 보겠습니다. 분류까지 끝난 직후 프로세스가 종료되면 다음 실행에서 재개할 지점을 정해야 합니다. 진행 상태를 메모리에만 뒀다면 완료한 작업과 남은 작업을 구분하기 어렵습니다. 처음부터 다시 실행하면 같은 API 호출에 비용을 한 번 더 쓸 수도 있습니다.
pg_durable은 작업을 SQL 단계로 정의하고 실행 상태를 PostgreSQL에 저장하는 확장입니다. 데이터베이스 안의 백그라운드 워커가 등록된 작업을 별도로 실행합니다. 체크포인트는 재개에 필요한 상태를 저장한 지점입니다. 실행이 중단되면 저장된 체크포인트를 기준으로 작업을 이어갑니다.
이 구조를 이해할 때는 작업을 다시 시작할 수 있는지와, 다시 실행해도 같은 결과가 유지되는지를 함께 살펴봐야 합니다.
함수 호출이 끝나도 작업은 진행 중일 수 있습니다
일반적인 함수 호출에서는 반환값을 받으면 함수 실행이 끝났다고 생각하기 쉽습니다. 하지만 백그라운드 작업을 등록하는 호출은 실행할 작업을 먼저 저장하고, 나중에 워커가 처리하도록 할 수 있습니다. 작업 ID를 받았다는 사실만으로 분류 결과가 저장됐다고 판단하면 안 됩니다.
pg_durable의 df.start()도 작업을 시작하고 인스턴스 ID를 반환합니다. 완료 여부와 결과는 별도로 조회합니다. 사용자 가이드의 기본 예제를 다음처럼 확인할 수 있습니다. 확장과 백그라운드 워커가 준비된 데이터베이스를 전제로 합니다.
SELECT df.start('SELECT 1' ~> 'SELECT 2');
SELECT * FROM df.list_instances();
~>는 앞 단계를 마친 뒤 다음 단계를 실행하도록 연결합니다. 첫 쿼리는 두 단계로 구성된 작업을 등록합니다. 두 번째 쿼리는 등록된 작업들의 상태를 조회합니다. 이 예제에서는 작업 등록과 상태 조회의 차이만 확인합니다.
기본 설정에서 df.start()는 호출자의 트랜잭션에 참여합니다. 트랜잭션은 여러 데이터 변경을 함께 확정하거나 취소하는 단위입니다. 작업을 등록한 트랜잭션을 롤백하면 그 작업도 실행되지 않습니다. 작업 ID를 받았더라도 등록 트랜잭션이 커밋됐는지 확인해야 합니다.
재개 지점과 외부 API의 처리 결과
문서 doc-42를 분류하는 예시에서는 입력 문서를 읽는 단계, 분류 API를 호출하는 단계, 분류 결과를 저장하는 단계가 있습니다. 앞 단계의 완료 상태가 확정됐다면 재개할 때 그 상태를 이용할 수 있습니다. 아직 완료를 기록하지 못한 단계는 다시 처리할 가능성을 고려해야 합니다.
특히 외부 API 호출에는 두 시스템의 상태가 관련됩니다. 외부 서버가 분류를 마쳤지만 응답을 받기 전에 연결이 끊길 수 있습니다. 호출한 쪽에는 성공 기록이 없어도 외부 서버에는 처리 결과가 남아 있을 수 있습니다. 데이터베이스에 실행 상태를 저장하는 기능만으로 이 불확실성이 사라지지는 않습니다.
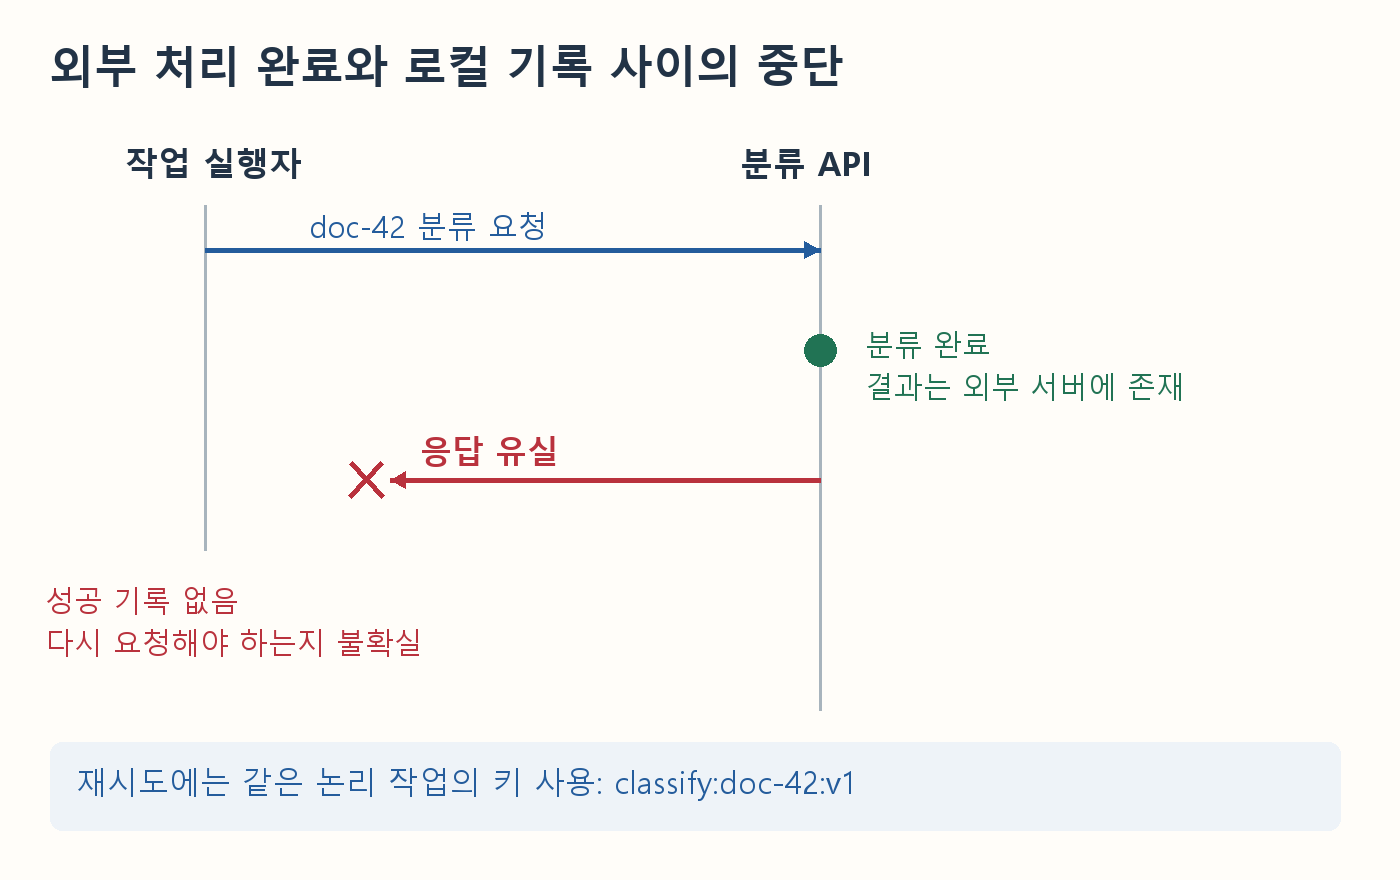
외부 서버는 처리를 완료했지만 호출자는 응답을 받지 못한 예시입니다. 재시도 여부를 정하려면 외부 처리 결과를 확인하거나 중복 요청을 식별할 방법이 필요합니다.
같은 요청을 여러 번 처리해도 결과가 한 번 처리한 것과 같도록 만드는 성질을 멱등성이라고 합니다. 외부 API가 멱등성 키를 지원한다면 같은 논리 작업의 재시도에는 같은 키를 보냅니다. 예를 들어 문서 ID와 분류 규칙 버전을 합친 classify:doc-42:v1을 사용할 수 있습니다. 재시도마다 새 키를 만들면 서버가 같은 작업임을 알아볼 수 없습니다.
키만 보낸다고 중복이 방지되는 것은 아닙니다. 외부 서버가 키를 저장하고 중복 요청의 결과를 재사용해야 합니다. 키의 보존 기간과 같은 키에 다른 입력을 보냈을 때의 동작도 확인합니다. API가 이런 기능을 제공하지 않으면 저장된 결과를 조회하거나 별도의 중복 처리 규칙을 설계해야 합니다.
분류 결과를 저장할 때도 논리 작업의 식별자를 유지합니다. 문서 ID와 규칙 버전에 고유 제약을 두면 같은 결과 행이 두 번 생기는 일을 막을 수 있습니다. 다만 고유 제약은 결과 저장의 중복을 막습니다. 이미 발생한 외부 API 호출 비용까지 되돌리지는 않습니다.
실패 종류에 맞춘 재시도
일시적인 연결 끊김은 재시도 후 성공할 수 있습니다. 반면 잘못된 입력이나 필요한 권한이 없는 요청은 같은 입력으로 반복해도 실패할 수 있습니다. 두 경우를 같은 재시도 규칙으로 처리하면 작업이 실패 원인을 남기지 못한 채 계속 대기할 수 있습니다.
작업마다 최대 시도 횟수, 다음 시도 시각, 마지막 오류를 확인할 수 있어야 합니다. 재시도 간격을 늘리는 규칙은 반복 요청의 빈도를 줄입니다. 실패 원인을 고치는 역할까지 맡지는 않습니다. 입력을 수정해야 하는 작업은 자동 재시도 대상에서 분리해 운영자가 확인할 수 있게 합니다.
완료 상태를 조회하는 쪽도 전체 작업의 상태와 단계별 결과를 구분합니다. 분류 API 호출이 성공했어도 결과 저장이 실패했다면 문서 처리가 끝났다고 표시할 수 없습니다. 사용자에게 완료를 알릴 기준은 필요한 최종 데이터가 저장됐는지에 맞춥니다.
PostgreSQL 안에서 실행할 작업의 범위
pg_durable을 사용하려면 해당 PostgreSQL 환경에서 확장을 설치하고 백그라운드 워커를 실행할 수 있어야 합니다. 데이터베이스를 사용할 수 있다는 사실만으로 이 조건이 충족되지는 않습니다. 운영 환경의 확장 허용 여부와 설치 절차를 먼저 확인합니다.
작업 상태와 대상 데이터가 같은 PostgreSQL에 있다면 SQL로 함께 살펴볼 수 있습니다. 대신 워크플로 실행도 데이터베이스 자원을 사용하므로 동시 실행 수와 연결 수, 상태 기록의 보관량을 점검해야 합니다. 대부분의 처리가 외부 시스템에서 이뤄지거나 SQL로 표현하기 어려운 애플리케이션 로직이 많다면 별도의 실행 도구를 검토할 수 있습니다.
도입을 검토할 때는 테스트 환경에서 단계 사이의 중단을 재현합니다. 완료한 단계가 어떻게 보존되는지, 응답을 잃은 외부 요청이 어떻게 처리되는지, 재시도 횟수가 끝난 작업을 어디서 확인하는지 살펴봅니다. 재개 기능과 중복 처리 규칙을 함께 확인해야 작업이 중단된 뒤에도 결과를 판단할 수 있습니다.